
AI vyhledávání: jak se dostat do odpovědí Googlu a ChatGPT
Přehledy od AI, režim AI, ChatGPT i Seznam AI odpovídají přímo ve vyhledávání. Ukážeme, jak vybírají zdroje, za co neplatit a co na webu upravit do 30 dní.
Spočítali jsme, kolik největších českých webů a e-shopů nepouští ChatGPT, Claude a Perplexity. Řadu blokací robots.txt neukáže – rozhoduje firewall a často platforma.
Čtvrtina největších českých webů nepouští aspoň jednoho AI robota. V našem průzkumu z 19. 11. 2026 to platí pro 208 z 819 dostupných webů z tisícovky domén .cz (25,4 %) a pro 284 z 1 223 e-shopů (23,2 %). Blokování AI robotů přitom často dělá jen firewall (dolní odhad: třetina až polovina případů u ChatGPT) a soubor robots.txt o něm mlčí. Chcete-li, aby vás ChatGPT, Claude nebo Perplexity v odpovědích zmiňovaly, nestačí zkontrolovat AI roboty v robots.txt – rozhodovat může firewall nebo platforma e-shopu.
Roboty AI stahují web buď pro učení modelů (GPTBot, ClaudeBot), nebo pro odpovědi s odkazem (OAI-SearchBot, Claude-SearchBot, PerplexityBot). Soubor robots.txt (např. vasweb.cz/robots.txt) je veřejná cedule na dveřích, kterou slušný robot respektuje. Firewall (hosting či Cloudflare) funguje jako vrátný: robota nepustí, i když robots.txt mlčí.
Změřili jsme 1 000 domén .cz z žebříčku Tranco (stránku vrátilo 819, což je základ podílů) a zvlášť 1 223 e-shopů mezi 5 120 doménami .cz v žebříčku.
| Co jsme zjistili | Top 1 000 (819 webů) | E-shopy (1 223) |
|---|---|---|
| Nepouští aspoň jednoho AI robota | 208 (25,4 %) | 284 (23,2 %) |
| GPTBot zakázán v robots.txt | 97 (11,8 %) | 96 (7,8 %) |
| GPTBot odmítnut firewallem | 83 (10,1 %) | 137 (11,2 %) |
| z toho bez zákazu v robots.txt | 49 | 82 |
| Vyhledávací AI robot zakázán v robots.txt | 41 (5,0 %) | 27 (2,2 %) |
| Vyhledávací AI robot odmítnut firewallem | 65 (7,9 %) | 84 (6,9 %) |
| Soubor llms.txt | 85 (10,4 %) | 294 (24,0 %) |
Čísla za firewall jsou vždy dolní odhad: počítáme jen výslovné odmítnutí tam, kde ve stejné minutě prošel běžný prohlížeč i kontrolní dotaz. V robots.txt zakazují GPTBot například idnes.cz, mapy.cz, vinted.cz, denik.cz, aktualne.cz, lidovky.cz, irozhlas.cz a hn.cz.
Silně chráněné weby nám stránku vůbec nevrátily, takže v základu 819 webů chybí. Ze všech 807 čitelných robots.txt z tisícovky ale GPTBot zakazuje 127 (15,7 %). Chráněné weby tedy blokují častěji a hlavní čísla jsou spíš podhodnocená.
Z tisícovky domén nepouští GPTBot 146 webů (z 819): 63 jen v robots.txt, 34 obojím a 49 (34 %) jen firewallem (dolní odhad). U e-shopů jde o 178 obchodů (z 1 223), z toho 82 (46 %) jen firewallem (dolní odhad).
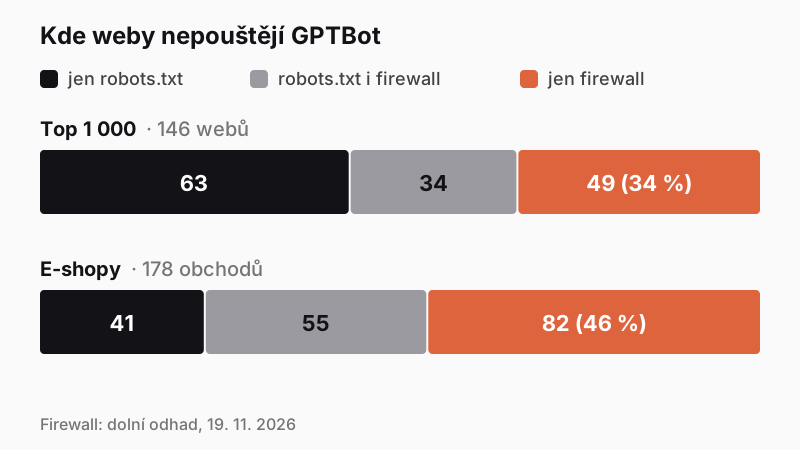
E-shopy blokují GPTBot víc firewallem (137 z 1 223, dolní odhad) než v robots.txt (96 z 1 223). Dřívější průzkumy četly jen robots.txt. Přitom 191 z 819 velkých webů (23,3 %) běží přes Cloudflare: ten stojí za 55 z 83 firewallových blokací GPTBotu u velkých webů a za 79 ze 137 u e-shopů (dolní odhady). Zbytek odmítá server či hosting.
Cloudflare navíc u 29 webů z tisícovky a 42 e-shopů sám vkládá do robots.txt blok „BEGIN Cloudflare Managed content“, který vždy zakazuje GPTBot. Dělá to při zapnutém blokování AI v nastavení zóny – zda to majitel zapnul vědomě, zvenku nepoznáme.
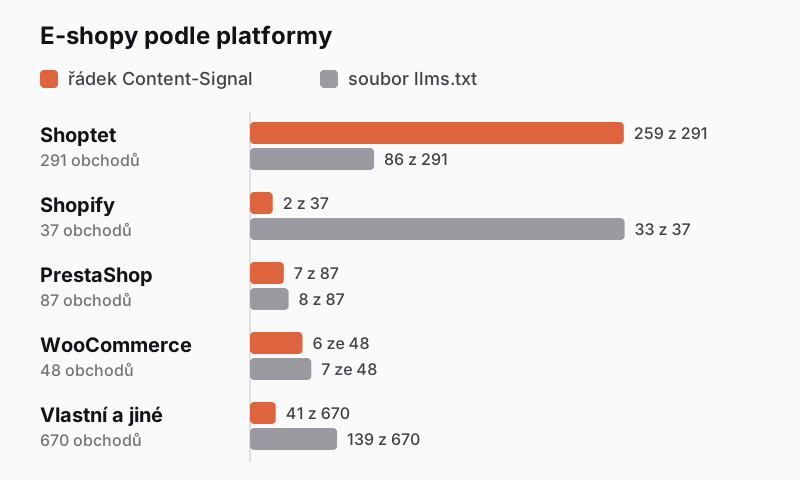
U e-shopů o robots.txt pro AI roboty často rozhoduje platforma, ne obchodník. Na Shoptetu má Content-Signal 259 z 291 obchodů: 232 zakazuje učení AI (ai-train=no) a 190 má přesně „search=yes, ai-train=no“.
Content-Signal od Cloudflare uvádí, zda AI smí obsah použít pro vyhledávání (search), odpovědi (ai-input) nebo učení (ai-train). Jde ale jen o prohlášení – GPTBot v robots.txt zakazují jen 4 z 291 obchodů na Shoptetu. Zda ho roboti respektují, je na nich.
Podobně platformy ovlivňují llms.txt, který modelům shrnuje obsah webu. Má ho 294 z 1 223 e-shopů (24,0 %), u velkých webů jen 85 z 819 (10,4 %):
Zda se llms.txt vyplatí, píšeme v článku o AI vyhledávání.
Platforma nebo hosting určuje i firewall, který odmítá GPTBot (dolní odhad):
Máte e-shop na pronajaté platformě? Zkontrolujte v robots.txt, co tam nastavila za vás. Možnosti nastavení srovnáváme v porovnání platforem.
Vyhledávací roboty pro ChatGPT, Claude a Perplexity zakazuje v robots.txt jen 41 z 819 velkých webů (5,0 %) a 27 z 1 223 e-shopů (2,2 %). Na firewallu ale OAI-SearchBot či PerplexityBot odmítá nejméně 65 velkých webů (7,9 %) a 84 e-shopů (6,9 %) – u obou jde o dolní odhad.
Výrobci roboty rozlišují takto:
V robots.txt zakazují vyhledávací roboty hlavně zpravodajské a inzertní weby, například idnes.cz, denik.cz, zive.cz, ceskenoviny.cz a sreality.cz. Jde o veřejné řádky v jejich robots.txt.
Z 819 dostupných webů firewall odmítá nejčastěji ClaudeBot (92), GPTBot (83), PerplexityBot (59) a OAI-SearchBot (14) – vše dolní odhad. Plošné blokování AI robotů tak může web vyřadit i z odpovědí s odkazem, i když majitel chtěl zakázat jen učení.
V robots.txt dnes GPTBot zakazuje 97 z 1 000 domén .cz žebříčku Tranco (11,8 % z 819 dostupných, 9,7 % celkem). Roku 2024 jich Apify našlo 21 v jiném žebříčku podle návštěvnosti; Lupa.cz 2. 9. 2024 uvedla „pouhá tři procenta“. Jde o čtyř- až pětinásobek, ale z různých seznamů webů. Apify navíc měřilo před spravovaným robots.txt Cloudflare, který dnes blokuje 29 webů.
Piperic podle Britských listů v červenci 2026 našel zákaz jakéhokoli robota AI na celém českém webu u 2,9 % z 224 452 webů a 1,9 % z 28 103 e-shopů, bez firewallu. Mezi největšími zakazuje v robots.txt aspoň jednoho robota pro učení 152 z 819 webů (18,6 %) a 177 z 1 223 e-shopů (14,5 %). Obě čísla měří něco jiného.
| Průzkum | Kdy | Weby | Co měřil | Výsledek |
|---|---|---|---|---|
| Apify (podle Lupa.cz) | září 2024 | 1 000 nejnavštěvovanějších | robots.txt | GPTBot zakázán na 21 webech |
| Piperic (podle Britských listů) | červenec 2026 | 224 452 aktivních | robots.txt, llms.txt | 2,9 % zakazuje robota AI |
| Guap Media | 19. 11. 2026 | 819 z top 1 000 a 1 223 e-shopů | robots.txt, llms.txt, firewall | GPTBot zakázán na 97 webech, robot AI nepuštěn na 208 |
U Studia Silex (2026) vrátilo 5 ze 14 webů chybu 403; autoři to připsali ověřování robotů podle IP adresy, ne blokaci AI. Ty řadíme do „nelze rozlišit“, ne mezi blokace.
Jestli váš web AI roboty pouští, zjistíte za pár minut ve třech krocích:
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://www.vasweb.cz/
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" https://www.vasweb.cz/Kontrolu zopakujte po každém přesunu domény, změně hostingu nebo platformy – právě tehdy se nastavení mění bez vašeho vědomí. Co dalšího pohlídat, popisujeme v článku Redesign webu bez ztráty návštěvnosti.
O přístupu AI robotů rozhodněte ve dvou krocích podle toho, zda jde o váš obsah, nebo chcete doporučení od AI. Výsledek má odpovídat vaší volbě, ne výchozímu nastavení:
Jak se dostat do odpovědí AI, shrnuje článek AI vyhledávání, základy pak Co můžete udělat pro SEO své firmy. S viditelností vám pomůžeme v našich marketingových službách.
Měřili jsme 19. 11. 2026 z jednoho počítače v Praze s domácí IP adresou. Na každý web šlo nejvýš osm dotazů po jednom a nic jsme neobcházeli – celkem 22 459 dotazů za necelých 15 minut.
Seznamy webů. Pořadí bereme z žebříčku Tranco, seznam L5KW4 z 18. 11. 2026 (30denní průměr z pěti zdrojů). Měří oblíbenost domén, ne návštěvnost, a tisícovka .cz zahrnuje i technické domény. Stránku nevrátilo 181 z 1 000 domén (130 odmítlo prohlížeč, 51 neodpovědělo); do podílů nevstupují.
E-shopy. Z 5 120 domén .cz jsme vybrali weby se značkou platformy a košíkem, případně s košíkem a aspoň dvěma z pěti znaků prodeje. Z ručně ověřených 40 webů byly obchodem všechny kromě nejvýš dvou sporných. Spadnou sem i hostingy s košíkem, tržiště a prodejci vstupenek; chybí obchody mimo .cz (.com, .eu), weby vykreslené JavaScriptem a ty, které odmítly prohlížeč. „Vlastní a jiné“ zahrnuje i platformy nepoznané z HTML.
Co jsme stahovali. Úvodní stránku, robots.txt a llms.txt jako prohlížeč, pak úvodní stránku pětkrát za GPTBot, kontrolní Googlebot, OAI-SearchBot, ClaudeBot a PerplexityBot.
Robots.txt. Čteme podle normy RFC 9309. Jako blokaci počítáme jen zákaz celého webu; částečné zákazy a weby zavřené všem robotům včetně Googlu vedeme zvlášť.
Firewall. Blokací je jen výslovné odmítnutí (401, 403, 406 a 451), když ve stejné minutě prošel prohlížeč i Googlebot – proto jde o dolní odhad. Se započtením kódů 429 a 5xx (mohou znamenat i přetížení) odmítá GPTBot 99 z 819 velkých webů a 193 z 1 223 e-shopů. Weby odmítající GPTBot i Googlebot řadíme do skupiny „nelze rozlišit“ (23 z 819 a 45 z 1 223) a mezi blokace je nepočítáme.
Co průzkum zvenku nepozná:
Data ke stažení. Zveřejňujeme jen veřejné soubory pro všech 1 900 webů v základu podílů (pořadí, verdikty robots.txt pro 22 robotů AI a Googlebot, llms.txt, Content-Signal a spravovaný blok Cloudflaru) v tabulce ve formátu CSV. Firewall po webech nezveřejňujeme, protože zvenku nejde ověřit chování ke skutečnému robotu.
Pokud byste chtěli nastavení robotů AI u svého webu projít s námi, napište nám, co potřebujete.
Otevřete adresu vasweb.cz/robots.txt a hledejte u robotů GPTBot a OAI-SearchBot řádek „Disallow: /“. Zkontrolujte i firewall (v Cloudflaru volbu AI Crawler and Agent access policies) a zkušební dotaz s hlavičkou robota. V našem průzkumu totiž robots.txt o blokaci mlčel u 49 ze 146 velkých webů, které GPTBot nepouštějí.
Do robots.txt přidejte „User-agent:“ se jménem robota a pod něj „Disallow: /“. Tím web zakážete jen robotům, kteří pravidla dodržují; spolehlivější je firewall. Zvažte přitom typ robota: z odpovědí s odkazem vás vyřadí jen zákaz vyhledávacích robotů, ne robotů pro učení.
Oba patří OpenAI (ChatGPT). GPTBot sbírá data pro učení modelů a jeho zákaz vyhledávání neovlivní. OAI-SearchBot slouží pro vyhledávání – pokud ho zakážete, v odpovědích ChatGPT se nezobrazíte.
Content-Signal určuje, zda smí AI obsah použít pro vyhledávání (search), odpovědi (ai-input) či učení (ai-train). Hodnota „ai-train=no“ učení odmítá, robota ale nezablokuje. Tento řádek měla většina e-shopů na Shoptetu, GPTBot však zakazovaly jen 4 z 291.
Vybíráme pro vás zajímavá témata
Přehledy od AI, režim AI, ChatGPT i Seznam AI odpovídají přímo ve vyhledávání. Ukážeme, jak vybírají zdroje, za co neplatit a co na webu upravit do 30 dní.
Přečtěte si naše tipy na zlepešní pozice vaší stránky ve vyhledávání a získejte tak nové zákazníky zdarma
Většině začínajících e-shopů stačí pronajatá platforma. Ukážeme vám, jak poznat, kdy už nestačí a kdy je vývoj na míru zbytečný výdaj.